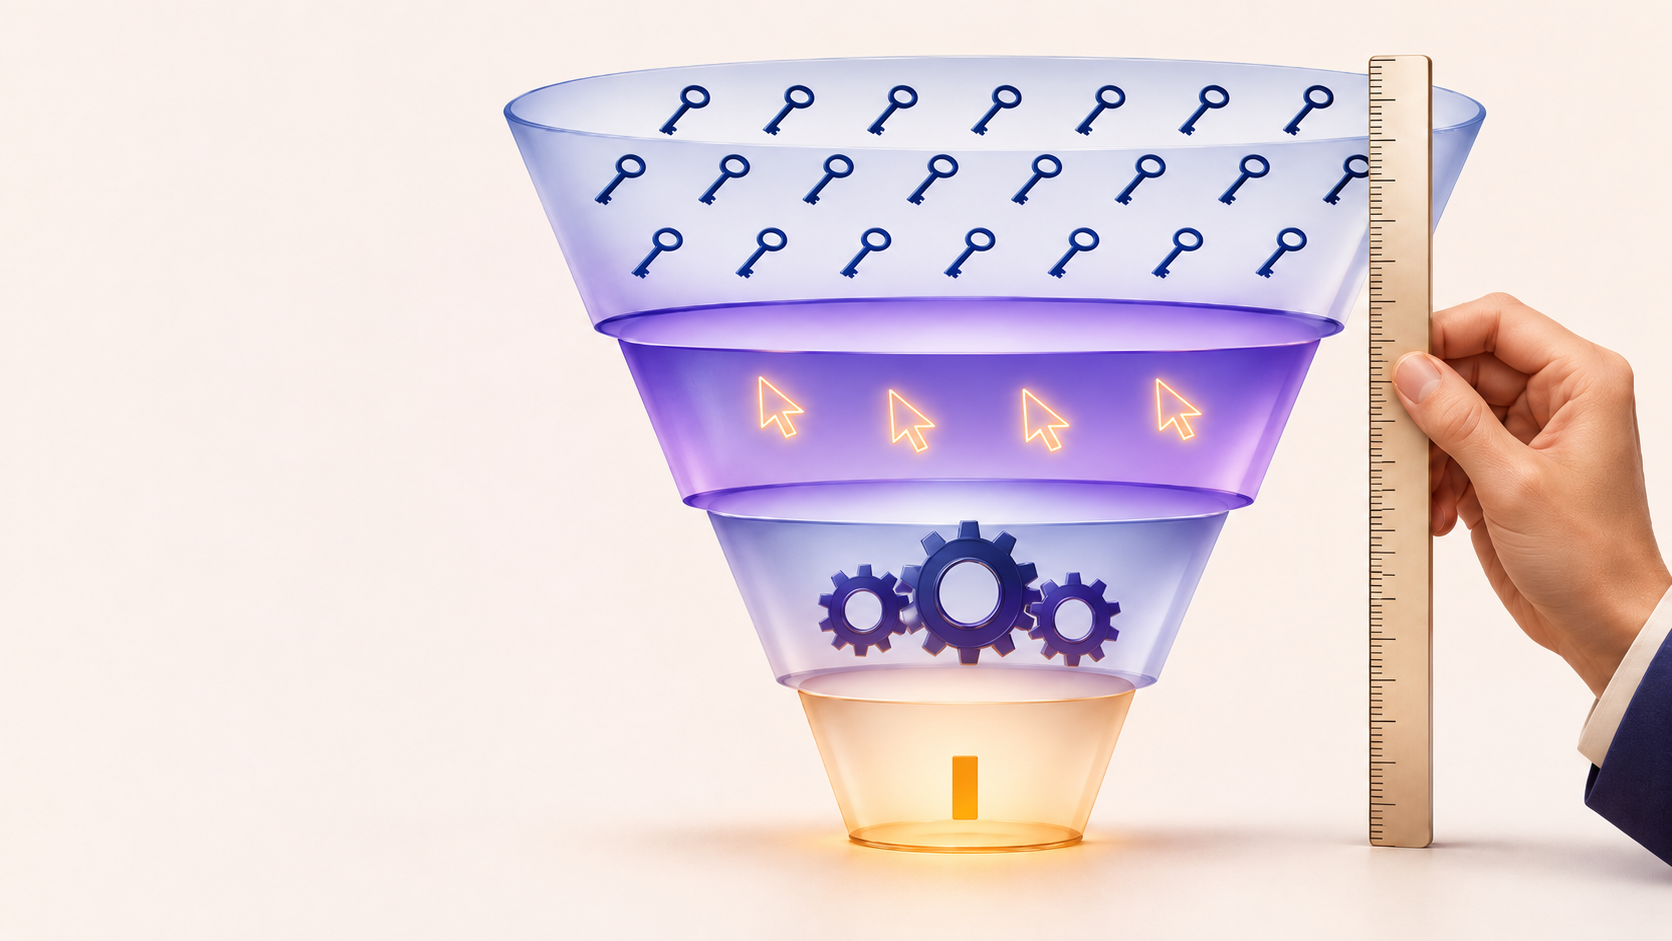
Tener IA disponible, usarla, integrarla en los procesos y obtener resultados son cuatro hechos distintos. Un tablero mínimo de ocho indicadores, con fórmulas y ejemplos, para saber en cuál está tu empresa y qué decidir en los próximos 90 días.
Resumen ejecutivo · TL;DR
«Tenemos 80 % de adopción» casi nunca responde lo que la dirección pregunta. Los paneles de los proveedores cuentan como activo a quien usó la herramienta una vez en cuatro semanas, y el mismo despliegue puede arrojar 80 %, 64 % o 21 % según la ventana con que se mida. Propongo separar cuatro preguntas —actividad, adopción, transformación e impacto— y responderlas con ocho indicadores que salen de registros, no de encuestas: el directorio de personal, el panel de la herramienta, un inventario de procesos y los sistemas donde ya se hace el trabajo. Ninguno reemplaza al siguiente, ninguno debe volverse una meta por sí solo, y más uso no siempre es mejor. El tablero de ejemplo es interactivo y acepta tus datos.
La lámina que todos aplauden
En las reuniones de dirección donde me piden «un diagnóstico de adopción de IA», casi siempre me muestran primero la misma lámina: cuántas licencias se compraron, a cuántas personas se capacitó y cuántos pilotos —pruebas acotadas antes de desplegar en grande— están en marcha. Es una lámina honesta. Y casi nunca responde lo que la gerencia quiere saber.
Para no señalar a nadie, te presento a Aurora, una distribuidora mediana que no existe: es un caso ilustrativo y todas sus cifras son hipotéticas. Aurora tiene 600 empleados, compró 300 licencias de un asistente de IA, capacitó a la mayoría y lanzó seis pilotos. En el comité de fin de trimestre, el área de tecnología reporta «80 % de adopción». Hay aplausos.
Entonces la gerente general pregunta otra cosa. ¿Cuánto mejoraron los procesos? ¿Cuánto tiempo recuperamos? ¿Qué decisiones tomamos distinto? ¿Cuánto valor generó todo esto? Nadie miente al contestar, porque nadie tiene qué contestar.
Piensa en una olla a presión —olla exprés, según el país—. Comprarla no es cocinar con ella. Estrenarla un domingo no la vuelve parte del menú de la semana. Usarla tres veces por semana tampoco garantiza que en tu casa se coma mejor o se gaste menos gas. Y hay platos para los que es la herramienta equivocada: nadie fríe un huevo en olla a presión.
Tener, probar, incorporar y obtener un resultado son cuatro hechos distintos, y ninguno se deduce del anterior. El problema de Aurora no es que su 80 % sea falso. Es que responde una pregunta que nadie hizo.
Un mismo piloto, tres cifras de adopción

¿De dónde sale un 80 %? Casi siempre del panel del proveedor, y ahí conviene leer la letra pequeña. Microsoft cuenta como usuario activo de Copilot a quien realizó al menos una actividad en los 28 días previos. Una instrucción en cuatro semanas alcanza para entrar en el numerador.
El caso mejor documentado que conozco es el del gobierno británico, que probó ese asistente con 20.000 licencias en 12 organismos durante el último trimestre de 2024. El informe general definió adopción como «al menos una interacción en 30 días» y reportó 83 % en octubre y cerca de 80 % el resto del periodo. Uno de los organismos participantes, el Departamento de Negocios y Comercio, midió sus propias 1.000 licencias con otra ventana: 64 % de usuarios activos por semana y 21 % por día (30 % si no se cuentan fines de semana ni festivos).
El mismo producto, el mismo trimestre, tres cifras: 80, 64 y 21. Ninguna es mentira.
Un piloto, tres cifras
A escala de países ocurre igual. Una nota de la Reserva Federal reconcilia dos datos de Estados Unidos a finales de 2025: cerca de 18 % de las empresas había adoptado IA según la oficina del censo, y 78 % de la fuerza laboral trabajaba en empresas que la habían adoptado según una encuesta a ejecutivos. Una cuenta empresas, casi todas pequeñas; la otra pondera por empleo, donde pesan las grandes. El AI Index de Stanford recoge 88 % de las organizaciones encuestadas, mientras las estadísticas oficiales europeas y de la OCDE —la Organización para la Cooperación y el Desarrollo Económicos— rondan 20 % de las empresas.
Una cifra de adopción sin numerador, denominador y ventana no significa nada. Y un referente externo solo sirve si coincide en las tres cosas, lo que casi nunca pasa.
Cuatro preguntas, no un porcentaje
Cuando alguien dice «adopción» puede estar hablando de cuatro cosas.
Las cuatro capas · toca cada una
01 Actividad
- Pregunta
- ¿Quién puede usarla y quién la probó?
- Qué se observa
- Acceso y activación
- Qué no demuestra
- Que exista un hábito
- Se mide con
- Indicadores 1 y 2
02 Adopción
- Pregunta
- ¿Quién la usa de forma habitual en su trabajo?
- Qué se observa
- Recurrencia en el tiempo
- Qué no demuestra
- En qué proceso ni con qué efecto
- Se mide con
- Indicador 3
03 Transformación
- Pregunta
- ¿Qué procesos se ejecutan hoy de otra manera?
- Qué se observa
- Cobertura de procesos e integración en el flujo
- Qué no demuestra
- Que el proceso haya mejorado
- Se mide con
- Indicadores 4 y 5
04 Impacto
- Pregunta
- ¿Qué resultado mejoró y cuánto se debe a la IA?
- Qué se observa
- Resultado operativo con comparación, calidad, tiempo neto y valor realizado
- Qué no demuestra
- Nada más: es la última pregunta
- Se mide con
- Indicadores 6, 7 y 8
Productividad, calidad e impacto caben en una sola capa, medida en dos pasos: el indicador operativo y luego su conversión en dinero. La confianza —controles, competencias, uso responsable— no es una quinta capa: es una barrera que puede invalidar cualquiera de las cuatro.
Qué hago con «amplitud y profundidad»
La pareja breadth and depth se usa hoy con definiciones que no coinciden: para un estudio de London Business School, amplitud es el número de casos de uso; para OpenAI, el número de personas que usan la herramienta. No encontré un instrumento único del que deriven los demás.
Lo uso como dos ejes con denominadores distintos. La amplitud se calcula sobre todo lo elegible y responde dónde se usa. La profundidad se calcula solo donde ya hay uso y responde qué tan incorporada está. Así no confundes un área con pocos usuarios intensivos con una de muchos ocasionales.
Qué es estándar y qué no
- Estándares formales. No existe ninguno para medir adopción. El marco de gestión de riesgos de IA del Instituto Nacional de Estándares y Tecnología de Estados Unidos (NIST) y la norma ISO/IEC 42001 ordenan el gobierno y el riesgo; ninguno define una métrica de uso.
- Prácticas extendidas. Las definiciones de «usuario activo» de los proveedores. Son comunes, no neutrales: cada proveedor fija la vara con que se mide su producto.
- Propuestas de consultoría. Los informes de McKinsey, Boston Consulting Group (BCG) o Deloitte se basan en encuestas a directivos. En la de McKinsey de 2026, casi nueve de cada diez dicen usar IA en alguna función y 37 % le atribuye algún efecto en utilidades. Es lo que la gente responde, no lo que un sistema registró, y viene de una firma que vende transformación con IA. Las leo como hipótesis.
- Evidencia con método. Experimentos y evaluaciones con comparación. Son pocos y miden cosas muy concretas.
El tablero que sigue es síntesis mía de esas fuentes: las fórmulas se apoyan en definiciones documentadas; la selección es recomendación propia.
El tablero mínimo: ocho indicadores

Una decisión de diseño antes de empezar: este tablero no usa encuestas. Una encuesta mide lo que la gente recuerda, cree o prefiere contestar, y depende del lente de quien responde. Prefiero indicadores que se puedan rastrear hasta un hecho de la empresa: un inicio de sesión, una cotización, una devolución. La regla es simple: cada número del tablero debe poder abrirse hasta los registros que lo produjeron.
Un indicador clave de desempeño (KPI, por sus siglas en inglés) solo sirve, además, si dos personas distintas lo calculan y llegan al mismo número. Por eso, antes de las fórmulas, fija tres definiciones por escrito:
- Población elegible: personas cuyo cargo incluye tareas donde la herramienta es aplicable. No es toda la plantilla.
- Acción intencional: algo que la persona pidió —una instrucción, un resumen, aceptar una sugerencia—. Abrir el panel no cuenta.
- Ventanas: 28 días para activación y 12 semanas para hábito, con una fecha de corte fija.
Capa de actividad
1 · Acceso. Personas elegibles con accesoPersonas elegibles Datos: directorio de personal e inventario de licencias. En Aurora, 480 de los 600 empleados son elegibles y 300 tienen licencia: 62,5 %. Decide si amplías o recuperas licencias. Cuidado: mide lo que pagaste, no lo que pasa.
2 · Activación. Personas con al menos una acción intencional en 28 díasPersonas con acceso Datos: panel de la herramienta. En Aurora, 240 de 300: 80 %. Este era el número del aplauso. Decide dónde hay barreras de entrada. Cuidado: una sola acción basta para contar.
Capa de adopción
3 · Uso habitual. Personas activas en al menos 9 de 12 semanasPersonas activadas Datos: registro semanal del panel o de la consola de administración. En Aurora, 66 de 240: 27,5 %. Sobre los 480 elegibles, eso es 13,75 %. Decide si necesitas formación inicial o acompañamiento por rol. Cuidado: «9 de 12» es la regla que publica Microsoft para su nivel habitual y nadie la ha validado; calcula también «al menos la mitad de las semanas», que es la que usó un experimento con 7.137 trabajadores de 66 empresas. Ahí, con licencia asignada al azar, el trabajador promedio usó el asistente en 41 % de las semanas, y el promedio por empresa fue de 6,3 % a 75 %.
Capa de transformación
4 · Cobertura de procesos. Procesos con al menos un caso de uso verificadoProcesos donde la IA es aplicable Verificado quiere decir dos evidencias de tipo distinto: el procedimiento escrito menciona el paso, hay registros de uso recientes, existe una muestra de entregables o lo confirma el dueño del proceso con volumen. Datos: inventario de procesos. En Aurora, 6 de 40: 15 %. Decide dónde abrir casos nuevos. Cuidado: la elegibilidad es un juicio, y todos los procesos pesan igual aunque no importen igual.
5 · Integración en el flujo. Unidades de trabajo ejecutadas con el paso asistidoUnidades totales del proceso Una unidad es una cotización, un caso, una conciliación. Datos: el sistema del proceso con una marca simple, como una casilla «elaborado con asistente». En Aurora, 300 de 1.200 cotizaciones al mes: 25 %. Decide qué proceso rediseñar y dónde vale la pena medir resultados. Cuidado: una marca manual se infla o se olvida; audita una muestra.
Capa de impacto
6 · Resultado operativo con comparación. (Después − antes en el equipo con IA) − (después − antes en un equipo comparable sin IA) Datos: el sistema del proceso, con al menos ocho semanas a cada lado; nunca una encuesta. En Aurora, el tiempo de ciclo de una cotización —desde la solicitud hasta la entrega— bajó de 50 a 41 horas en la zona norte, que usa el asistente, y de 52 a 49 en la zona sur, que no lo usa. Efecto: −9 − (−3) = −6 horas, 12 % menos. Decide si escalas, corriges o detienes. Cuidado: si los equipos no eran parecidos antes, la resta no significa nada.
7 · Calidad y retrabajo. Unidades devueltas, corregidas o reabiertasUnidades cerradas Mismo diseño de comparación del indicador 6. En Aurora, las cotizaciones devueltas por error pasaron de 4 % a 6 % en el norte y siguieron en 4 % en el sur: dos puntos porcentuales más. Decide por encima del indicador 6: sin calidad estable no se escala. Cuidado: las tasas bajas necesitan mucho volumen para dejar de ser ruido.
8 · Tiempo neto recuperado y valor realizado. (Tiempo medido por unidad antes − después − tiempo añadido de revisión y corrección) × unidades asistidas En Aurora, el equipo dice ahorrar 30 minutos por cotización; el cronómetro mide 20; la revisión nueva consume 8. Neto: 12 minutos × 300 cotizaciones = 60 horas al mes. No contradice las 6 horas del indicador 6: aquellas son tiempo de ciclo, con la espera entre pasos; estas, tiempo de trabajo. Esas 60 horas son capacidad, no dinero. Se vuelven valor realizado solo en la parte que tiene un destino verificable: más cotizaciones atendidas, horas extra que dejaron de pagarse, una contratación que ya no hizo falta. Ese tramo lo desarrollé en el artículo sobre el ROI.
Dos alertas que acompañan al tablero
No son KPIs, pero cambian cómo lees los otros ocho. La concentración: qué parte de las acciones viene del 10 % más activo de quienes tienen acceso (en Aurora, 58 %); si es muy alta, tu adopción depende de unos pocos. Y el uso fuera de las herramientas provistas, también medido con hechos: tráfico agregado de la red corporativa hacia servicios de IA no autorizados, sin identificar personas, y pagos a esas herramientas en tarjetas corporativas o reembolsos. Si la gente trabaja con cuentas personales, el panel subestima el uso y la empresa no protege esa información.
Aurora en siete números
De 600 personas a 66 con hábito
Un núcleo común y lo demás a la medida
¿Cómo medir de forma comparable sin tratar igual a una pyme y a una multinacional? Dejando fijo lo que permite comparar y libre lo que depende del negocio.
Fijo: las tres definiciones y las ocho fórmulas. Libre: la unidad de trabajo, el indicador de resultado y la barrera de calidad, que cambian por área.
Desliza la tabla →
| Área | Unidad de trabajo | Indicador de resultado | Barrera de calidad |
|---|---|---|---|
| Comercial | Cotización o propuesta | Tiempo de ciclo; tasa de cierre | Cotizaciones devueltas por error |
| Operaciones | Orden o despacho | Órdenes por turno | Reprocesos y devoluciones |
| Finanzas | Conciliación o cierre | Días de cierre | Ajustes posteriores al cierre |
| Atención al cliente | Caso | Casos resueltos por hora | Casos reabiertos |
| Analítica | Informe o análisis | Tiempo de entrega | Correcciones tras la entrega |
Cambia la infraestructura, no las preguntas. Una pyme empieza con la exportación del panel, el inventario en una hoja de cálculo y el conteo de una muestra de unidades; una multinacional tendrá que unir varias herramientas sin contar dos veces a la misma persona.
Tres decisiones de diseño que te recomiendo sostener:
- No construyas un índice compuesto. De las tres investigaciones que contrasté para este artículo, una proponía un índice con ponderaciones de 45, 35 y 20 %, y niveles de madurez con umbrales numéricos. No encontré evidencia que justifique esos pesos ni ningún otro. Un índice esconde justo lo que necesitas ver; reporta los componentes.
- Habla de perfiles, no de niveles. Un área jurídica con pocos usos muy integrados puede estar exactamente donde debe.
- Reporta agregados por área, nunca por persona, y mantén estos números fuera de la evaluación de desempeño. Lo primero protege la privacidad; lo segundo, el dato.
Del tablero a la decisión
Un tablero que no cambia una decisión es decoración.
¿Qué ves en tu tablero? · elige una señal
Mucho acceso, poca activación
Hipótesis por investigar
La herramienta no aplica al trabajo del área; hay dudas de seguridad; nadie mostró para qué sirve
Acción de la dirección
No compres más licencias. Revisa con el dueño del proceso las tareas reales del área, envía recordatorios con casos concretos y reasigna las licencias dormidas
Activación alta, hábito bajo
Hipótesis por investigar
Efecto novedad; usos genéricos; formación general
Acción de la dirección
Elige uno o dos procesos de alto volumen y forma por rol sobre ese proceso
Uso frecuente, poca integración
Hipótesis por investigar
La IA vive en una ventana aparte y no en el paso donde se hace el trabajo
Acción de la dirección
Rediseña un paso del procedimiento y pon la marca en el sistema
Adopción declarada sin productividad; o tiempo ahorrado sin resultado
Hipótesis por investigar
El ahorro es percepción; la revisión se lo come; el cuello de botella está en otro paso; el tiempo no tiene destino
Acción de la dirección
Mide con comparación (indicadores 6 y 7) y decide antes qué harás con el tiempo
Unos equipos muy bien, el resto no
Hipótesis por investigar
Práctica no documentada; licencias mal repartidas; dependencia de personas clave
Acción de la dirección
Verifica primero la calidad del núcleo, documenta su práctica y extiéndela a pares con las mismas tareas
Las dos primeras acciones tienen precedente experimental, no garantía; las demás son criterio de consultoría. En tres experimentos con 4.867 desarrolladores, entre 30 y 40 % nunca probó el asistente aunque era gratuito, y en Microsoft dos correos de recordatorio llevaron la inscripción de 8,5 % a 42,5 %.
Los primeros 90 días
Hoja de ruta · 90 días
- 1
Días 1 a 30
Línea base
Escribe las definiciones. Levanta el inventario de procesos de dos o tres áreas. Calcula los indicadores 1 a 5 y revisa las dos alertas. Esa primera medición es tu línea base, el punto de partida contra el que compararás todo. Todavía no fijes metas.
- 2
Días 31 a 60
Procesos prioritarios
Elige dos o tres procesos con volumen y un dueño claro. Pon la marca del paso asistido. Define por adelantado el indicador de resultado, la barrera de calidad y la regla de decisión: «si mejora X sin que empeore Y, escalamos». Introduce la IA de forma escalonada: un equipo ahora, otro comparable dentro de ocho semanas.
- 3
Días 61 a 90
Segunda medición y decisión
Repite los indicadores 1 a 5, calcula del 6 al 8 y decide proceso por proceso: escalar, rediseñar o detener.
El escalonamiento es lo que separa observar una mejora de demostrar que la causó la IA: un antes y después simple no distingue la herramienta de la temporada o del entusiasmo del equipo. No necesitas un ensayo académico. Necesitas un grupo que todavía no la tenga.
- Antes y después
- Equipo comparable
- Despliegue escalonadoPlan de 90 días
- Asignación por sorteo
Y nunca reemplaces la medición por la percepción. En el primer experimento de METR —un instituto independiente que evalúa modelos de IA—, desarrolladores expertos tardaron 19 % más con IA y creyeron haber sido más rápidos. Sus mediciones posteriores ya no distinguen el efecto de cero, y la organización reconoce problemas de selección en su propio diseño. En Dinamarca, un estudio con registros administrativos descartó efectos superiores a 1 % sobre ingresos y horas trabajadas, pese a que los usuarios declaraban ahorrar 2,8 % de su tiempo.
Cuando menos IA es mejor
Vuelve a la olla a presión. Su valor no está en usarla más, sino en usarla donde corresponde.
La evaluación del Departamento de Negocios y Comercio observó tareas con y sin asistente, con muestras pequeñas.
Resumir informes
Más rápido y mejor con IA
Analizar datos en hoja de cálculo
Más lento y peor con IA
No halló evidencia robusta de que el tiempo ahorrado se tradujera en productividad. Un indicador de uso habría premiado las dos tareas por igual.
La métrica se vuelve la meta. Si premias la activación, tendrás activación: acciones triviales para aparecer en el panel. Por eso el tablero ordena áreas y no califica personas.
El panel estima lo que no midió. Las «horas asistidas» de Microsoft multiplican cada acción por seis minutos y por una tarifa de 72 dólares la hora. La documentación las describe como aproximaciones amplias. Son útiles para ver tendencias y no como evidencia de valor.
Los costos que no aparecen en la lámina. Revisar, corregir y mantener también es trabajo. En el blog lo llamé deuda de revisión, y es la razón por la que el indicador 8 resta antes de multiplicar. Súmale el consumo de los modelos, que crece con el uso y rara vez se reparte por proceso.
Dónde la evidencia es floja
Desliza la tabla →
| Afirmación de este artículo | En qué se apoya | Precaución |
|---|---|---|
| La cifra de adopción depende de la ventana | Evaluaciones públicas británicas y documentación de proveedores | Sector público, un producto, licencias repartidas en parte a voluntarios |
| El uso no implica productividad | Evaluación con tareas observadas; experimento en 66 empresas; registros daneses | Muestras de observación pequeñas; tres de los cuatro autores del experimento trabajan en Microsoft; un solo país |
| La percepción de ahorro no es fiable | Experimento de METR | Dieciséis desarrolladores en la primera medición; resultados posteriores inestables |
| Recordatorios y formación por rol mueven la activación | Experimentos de campo | Estimaciones ruidosas; sector de software |
| Umbral de «9 de 12 semanas» | Regla de un proveedor | Sin validación: nadie ha mostrado que prediga permanencia ni resultados |
| Uso fuera de las herramientas provistas medido por tráfico de red | Práctica de seguridad informática | Solo ve la red corporativa: el celular personal queda fuera. Es una cota inferior |
| Cobertura de procesos, integración, regla de dos evidencias y las cuatro capas | Síntesis y diseño míos | No están probados comparativamente en una cartera real |
Tres vacíos pesan más que los demás. No encontré ningún caso empresarial de América Latina que publique su métrica de adopción con método. No hay estadística oficial reciente y comparable: en Colombia, la última encuesta oficial de tecnología en empresas tiene como referencia 2020, antes de la IA generativa. Y ninguna fuente publica qué parte de su actividad viene del 10 % más activo.
Salvedad sobre mi propio argumento
El razonamiento me parece sólido: separar capas evita confundir un indicador con el siguiente. La selección exacta de ocho indicadores no la defendería como única. Y hay un costo que no resolví: medir integración y resultado exige marcar sistemas y sostener grupos de comparación, y una empresa pequeña puede gastar en medir más de lo que la IA le devuelve. Para ella, tres números —uso habitual, un proceso marcado y su indicador con comparación— pueden ser todo el tablero. Y renunciar a las encuestas tiene un precio: los registros dicen qué pasó, no por qué. Cuando un área no usa la herramienta, la razón no está en ningún sistema; hay que sentarse con quien hace el trabajo. Eso es diagnóstico, no indicador, y por eso no entra al tablero.
¿Qué me haría cambiar de opinión? Ver, en datos de varias empresas, que la activación a 28 días predice por sí sola el resultado operativo meses después. Si eso se sostuviera, casi todo este tablero sobraría.
Conclusión
Aurora no estaba atrasada ni adelantada. Estaba midiendo la compra de la olla.
Cuando separó las cuatro preguntas, dejó de discutir si 80 % era mucho o poco y empezó a discutir por qué un solo proceso pasaba por la IA, por qué ese proceso iba más rápido con más errores y adónde se iban sesenta horas al mes. Ninguna de esas conversaciones necesitó una plataforma nueva. Necesitó definiciones, una hoja de cálculo y la disposición a mirar un número menos halagador.
Tal vez la medida más honesta de madurez sea esa: cuánto tarda una empresa en cambiar la pregunta. Ya no cuánta inteligencia artificial utiliza, sino qué está logrando hacer mejor gracias a ella, y con qué evidencia podría demostrárselo a alguien que no estuvo en el comité.
Preguntas frecuentes
¿Qué es la adopción de IA en una empresa?
Es el grado en que la inteligencia artificial se usa de forma habitual en el trabajo real, no la cantidad de licencias compradas ni de personas capacitadas. Conviene separarla de la actividad (acceso y primer uso), de la transformación (procesos que cambiaron) y del impacto (resultados verificables). Cada una se mide con un indicador distinto.
¿Cómo se calcula la tasa de adopción de IA?
Depende de qué quieras saber. La activación divide las personas con al menos una acción en 28 días entre las personas con acceso. El uso habitual divide las personas activas en al menos 9 de 12 semanas entre las activadas. Indica siempre numerador, denominador y ventana, porque el mismo despliegue puede dar 80 % o 21 % según la definición.
¿Cuántos KPIs necesito para medir la adopción de IA?
Con ocho se cubren las cuatro capas: acceso, activación, uso habitual, cobertura de procesos, integración en el flujo, resultado operativo con comparación, calidad y retrabajo, y tiempo neto recuperado. Una empresa pequeña puede empezar con tres: uso habitual, un proceso marcado y su indicador de resultado con un equipo de comparación.
¿Existe un estándar para medir la adopción de IA?
No. El marco de riesgos del NIST y la norma ISO/IEC 42001 tratan gobierno y gestión de riesgos, no métricas de uso. Lo que circula como «amplitud y profundidad» es un lente útil con definiciones que varían según el autor. Las métricas de los proveedores son prácticas extendidas, no normas.
¿El tiempo ahorrado con IA cuenta como productividad?
No por sí solo. El tiempo que la gente dice ahorrar suele ser mayor que el medido, y al medido hay que restarle el tiempo nuevo de revisión y corrección. Lo que queda es capacidad, y solo se vuelve valor cuando tiene un destino verificable, como más volumen atendido o un gasto que dejó de hacerse.
¿Hay una plantilla para calcular estos indicadores?
Sí. El tablero de adopción de IA calcula los ocho indicadores y las dos alertas con los datos de ejemplo de Aurora o con los tuyos, cargados desde plantillas en formato CSV. Muestra de dónde sale cada cifra y procesa los datos en tu navegador.
Fuentes y lecturas
En Philia Sophia
- Tablero de adopción de IA: plantilla interactiva con los ocho indicadores
- El ROI de la IA no se calcula: se demuestra
- AI-Native no es tener más IA: es aprender a rediseñar el trabajo
- El prompt no es el problema: 2 mapas para usar la IA con criterio
- Un agente no es solo el modelo: cuatro piezas para delegar con criterio
- Analítica de datos en 5 niveles
Evaluaciones públicas y documentación de proveedor
- Government Digital Service — Microsoft 365 Copilot Experiment: cross-government findings
- Department for Business and Trade — Microsoft 365 Copilot evaluation
- Microsoft Learn — Copilot Dashboard: definiciones de métricas (documentación de proveedor)
Estudios con método
- Dillon, Jaffe, Immorlica y Stanton — experimento en 66 empresas
- Cui et al. — tres experimentos con desarrolladores
- Humlum y Vestergaard — Large Language Models, Small Labor Market Effects
- METR — actualización de sus experimentos de productividad
- Reserva Federal — Monitoring AI Adoption in the U.S. Economy
Encuestas citadas como contraste (declarativas)
¿Tu comité aplaude un porcentaje o responde las cuatro preguntas?
Puedo ayudarte a levantar la línea base, elegir los procesos y montar el tablero mínimo de tu empresa. Si prefieres empezar por tu cuenta, el tablero es gratuito.
Conversemos por WhatsAppNota de transparencia. Este artículo fue investigado y escrito por Javier Forero Ruiz con asistencia de inteligencia artificial para búsqueda, contraste de fuentes, edición y verificación. Parte de tres investigaciones profundas hechas con sistemas de IA distintos, cuyas conclusiones se contrastaron entre sí y contra las fuentes originales. Aurora es un caso ficticio y sus cifras son hipotéticas. Las tesis, la selección de evidencia y la responsabilidad editorial son mías.
Measuring AI adoption: it is not one percentage, it is four questions
Having AI available, using it, building it into your processes and getting results are four different facts. A minimum scorecard of eight metrics, with formulas and worked examples, to find out where your company stands and what to decide over the next 90 days.
Executive summary · TL;DR
«We have 80% adoption» almost never answers what leadership is asking. Vendor dashboards count anyone who used the tool once in four weeks as active, and the same rollout can show 80%, 64% or 21% depending on the window. I propose separating four questions—activity, adoption, transformation and impact—and answering them with eight metrics drawn from records, not surveys: the HR directory, the tool’s admin dashboard, a process inventory and the systems where the work already happens. None replaces the next one, none should become a target on its own, and more usage is not always better. The sample scorecard is interactive and takes your own data.
The slide everyone applauds
In the leadership meetings where I am asked for «an AI adoption assessment,» I am almost always shown the same slide first: how many licenses were bought, how many people were trained, and how many pilots are underway. It is an honest slide. And it almost never answers what the executive team wants to know.
So I don’t have to point at anyone, meet Northgate Supply, a mid-sized distributor that does not exist: it is an illustrative case and every one of its numbers is hypothetical. Northgate has 600 employees, bought 300 seats of an AI assistant, trained most of its people and launched six pilots. At the quarterly review, IT reports «80% adoption.» There is applause.
Then the CEO asks something else. How much better are our processes? How much time did we get back? Which decisions are we making differently? How much value did all of this create? Nobody lies in response, because nobody has a response.
Think of the air fryer you bought on Black Friday. Buying it is not cooking with it. Trying it once on a Sunday does not make it part of your weeknight routine. Using it three times a week does not guarantee your household eats better or spends less on takeout. And there are dishes it is simply the wrong tool for: nobody makes soup in an air fryer.
Owning, trying, building in and getting a result are four different facts, and none follows from the one before. Northgate’s problem is not that its 80% is false. It is that it answers a question nobody asked.
One pilot, three adoption numbers
Where does an 80% come from? Almost always from the vendor’s dashboard, and the fine print matters. Microsoft counts as an active Copilot user anyone who performed at least one activity in the previous 28 days. One prompt in four weeks is enough to land in the numerator.
The best-documented case I know is the UK government’s, which trialed that assistant with 20,000 licenses across 12 departments in the last quarter of 2024. The cross-government report defined adoption as «at least one interaction in 30 days» and reported 83% in October and around 80% for the rest of the period. One participating department, the Department for Business and Trade, measured its own 1,000 licenses on a different window: 64% weekly active users and 21% daily (30% if weekends and holidays are left out).
Same product, same quarter, three numbers: 80, 64 and 21. None of them is a lie.
One pilot, three numbers
It works the same way at national scale. A Federal Reserve note reconciles two US figures from late 2025: about 18% of firms had adopted AI according to the Census Bureau, while 78% of the labor force worked at firms that had adopted it according to an executive survey. One counts firms, most of them small; the other weights by employment, where large firms dominate. Stanford’s AI Index reports 88% of surveyed organizations, while official statistics in Europe and across the OECD—the Organisation for Economic Co-operation and Development—sit near 20% of firms.
An adoption figure without a numerator, a denominator and a window means nothing. And an outside benchmark only helps if it matches on all three, which almost never happens.
Four questions, not one percentage
When someone says «adoption» they may mean four different things.
The four layers · tap each one
01 Activity
- Question
- Who can use it, and who has tried it?
- What you observe
- Access and activation
- What it does not prove
- That a habit exists
- Measured with
- Metrics 1 and 2
02 Adoption
- Question
- Who uses it routinely in their work?
- What you observe
- Recurrence over time
- What it does not prove
- In which process, or to what effect
- Measured with
- Metric 3
03 Transformation
- Question
- Which processes now run differently?
- What you observe
- Process coverage and workflow integration
- What it does not prove
- That the process improved
- Measured with
- Metrics 4 and 5
04 Impact
- Question
- Which outcome improved, and how much of it is due to AI?
- What you observe
- Operating outcome against a comparison, quality, net time and realized value
- What it does not prove
- Nothing further: it is the last question
- Measured with
- Metrics 6, 7 and 8
Productivity, quality and impact fit in a single layer, measured in two steps: the operating metric, then its conversion into money. Trust—controls, skills, responsible use—is not a fifth layer: it is a guardrail that can invalidate any of the four.
What I do with «breadth and depth»
The breadth-and-depth pairing today carries definitions that do not match: for a London Business School study, breadth is the number of use cases; for OpenAI, the number of people using the tool. I found no single instrument the others derive from.
I use it as two axes with different denominators. Breadth is computed over everything eligible and answers where AI is used. Depth is computed only where use already exists and answers how embedded it is. That way you do not confuse a team of a few heavy users with one of many occasional users.
What is a standard and what is not
- Formal standards. None exists for measuring adoption. The AI Risk Management Framework from the US National Institute of Standards and Technology (NIST) and the ISO/IEC 42001 standard organize governance and risk; neither defines a usage metric.
- Common practice. Vendors’ «active user» definitions. They are common, not neutral: each vendor sets the yardstick its own product is measured by.
- Consulting proposals. Reports from McKinsey, Boston Consulting Group (BCG) or Deloitte rest on executive surveys. In McKinsey’s 2026 survey, nearly nine in ten say they use AI in at least one function and 37% attribute some bottom-line effect to it. That is what people answer, not what a system recorded, and it comes from a firm that sells AI transformation. I read them as hypotheses.
- Evidence with a method. Experiments and evaluations with a comparison group. There are few, and they measure very specific things.
The scorecard that follows is my synthesis of those sources: the formulas lean on documented definitions; the selection is my recommendation.
The minimum scorecard: eight metrics
One design decision before we start: this scorecard uses no surveys. A survey measures what people remember, believe or choose to say, and it depends on the lens of whoever answers. I prefer metrics you can trace back to something that happened in the business: a login, a quote, a return. The rule is simple: every number on the scorecard must open down to the records that produced it.
A key performance indicator (KPI) is also only useful if two different people compute it and land on the same number. So before the formulas, put three definitions in writing:
- Eligible population: people whose role includes tasks the tool applies to. Not the whole headcount.
- Intentional action: something the person asked for—a prompt, a summary, accepting a suggestion. Opening the panel does not count.
- Windows: 28 days for activation and 12 weeks for habit, with a fixed cutoff date.
Activity layer
1 · Access. Eligible people with accessEligible people Data: HR directory and license inventory. At Northgate, 480 of the 600 employees are eligible and 300 hold a seat: 62.5%. It decides whether you expand or reclaim licenses. Caution: it measures what you paid for, not what is happening.
2 · Activation. People with at least one intentional action in 28 daysPeople with access Data: the tool’s dashboard. At Northgate, 240 of 300: 80%. This was the number that got the applause. It decides where the barriers to entry are. Caution: a single action is enough to count.
Adoption layer
3 · Habitual use. People active in at least 9 of 12 weeksActivated people Data: the weekly log from the dashboard or admin console. At Northgate, 66 of 240: 27.5%. Over the 480 eligible people, that is 13.75%. It decides whether you need onboarding or role-based coaching. Caution: «9 of 12» is the rule Microsoft publishes for its habitual tier and nobody has validated it; also compute «at least half the weeks,» the one used by an experiment with 7,137 workers at 66 firms. There, with licenses assigned at random, the average worker used the assistant in 41% of weeks, and firm averages ranged from 6.3% to 75%.
Transformation layer
4 · Process coverage. Processes with at least one verified use caseProcesses where AI is applicable Verified means two pieces of evidence of different kinds: the written procedure mentions the step, there are recent usage logs, a sample of deliverables exists, or the process owner confirms it with volumes. Data: process inventory. At Northgate, 6 of 40: 15%. It decides where to open new use cases. Caution: eligibility is a judgment call, and every process weighs the same even though they do not matter the same.
5 · Workflow integration. Units of work executed with the assisted stepTotal units in the process A unit is a quote, a case, a reconciliation. Data: the system the process runs in, with a simple flag such as a «drafted with assistant» checkbox. At Northgate, 300 of 1,200 quotes a month: 25%. It decides which process to redesign and where outcomes are worth measuring. Caution: a manual flag gets inflated or forgotten; audit a sample.
Impact layer
6 · Operating outcome against a comparison. (After − before in the team with AI) − (after − before in a comparable team without it) Data: the process system, with at least eight weeks on each side; never a survey. At Northgate, quote cycle time—from request to delivery—fell from 50 to 41 hours in the Midwest region, which uses the assistant, and from 52 to 49 in the Southeast, which does not. Effect: −9 − (−3) = −6 hours, 12% less. It decides whether you scale, fix or stop. Caution: if the teams were not alike beforehand, the subtraction means nothing.
7 · Quality and rework. Units returned, corrected or reopenedUnits closed Same comparison design as metric 6. At Northgate, quotes sent back for errors went from 4% to 6% in the Midwest and stayed at 4% in the Southeast: two percentage points more. It overrides metric 6: without stable quality you do not scale. Caution: low rates need a lot of volume before they stop being noise.
8 · Net time recovered and realized value. (Measured time per unit before − after − added review and correction time) × assisted units At Northgate, the team says it saves 30 minutes per quote; the stopwatch says 20; the new review step takes 8. Net: 12 minutes × 300 quotes = 60 hours a month. This does not contradict the 6 hours in metric 6: those are cycle time, including waits between steps; these are working time. Those 60 hours are capacity, not money. They become realized value only for the part with a verifiable destination: more quotes handled, overtime no longer paid, a hire that was no longer needed. I covered that stretch in the ROI article (in Spanish).
Two alerts that travel with the scorecard
They are not KPIs, but they change how you read the other eight. Concentration: what share of actions comes from the most active 10% of people with access (58% at Northgate); if it is very high, your adoption depends on a few. And use outside the tools you provide, also measured with facts: aggregate corporate network traffic to unapproved AI services, with no individuals identified, and payments to those tools on corporate cards or expense reports. If people work from personal accounts, the dashboard understates usage and the company cannot protect that information.
Northgate in seven numbers
From 600 people to 66 habitual users
A common core, and the rest made to fit
How do you measure comparably without treating a small business and a multinational alike? By fixing what makes comparison possible and freeing what depends on the business.
Fixed: the three definitions and the eight formulas. Free: the unit of work, the outcome metric and the quality guardrail, which change by function.
Swipe the table →
| Function | Unit of work | Outcome metric | Quality guardrail |
|---|---|---|---|
| Sales | Quote or proposal | Cycle time; win rate | Quotes sent back for errors |
| Operations | Order or shipment | Orders per shift | Rework and returns |
| Finance | Reconciliation or close | Days to close | Post-close adjustments |
| Customer service | Case | Cases resolved per hour | Reopened cases |
| Analytics | Report or analysis | Turnaround time | Corrections after delivery |
The infrastructure changes; the questions do not. A small business starts with a dashboard export, the inventory in a spreadsheet and a count of a sample of units; a multinational will have to join several tools without counting the same person twice.
Three design decisions I recommend you hold on to:
- Do not build a composite index. Of the three research reports I cross-checked for this article, one proposed an index weighted 45, 35 and 20%, and maturity levels with numeric thresholds. I found no evidence to justify those weights or any others. An index hides exactly what you need to see; report the components.
- Talk about profiles, not levels. A legal team with a few deeply integrated uses may be exactly where it should be.
- Report aggregates by team, never by person, and keep these numbers out of performance reviews. The first protects privacy; the second protects the data.
From scorecard to decision
A scorecard that does not change a decision is decoration.
What does your scorecard show? · pick a signal
Lots of access, little activation
Hypotheses to investigate
The tool does not fit the team’s work; there are security concerns; nobody showed what it is for
What leadership does
Do not buy more licenses. Walk through the team’s actual tasks with the process owner, send reminders with concrete cases and reassign idle seats
High activation, low habit
Hypotheses to investigate
Novelty effect; generic uses; one-size-fits-all training
What leadership does
Pick one or two high-volume processes and train by role on that process
Frequent use, little integration
Hypotheses to investigate
AI lives in a separate window rather than in the step where the work gets done
What leadership does
Redesign one step of the procedure and put the flag in the system
Claimed adoption without productivity; or time saved without results
Hypotheses to investigate
The saving is perception; review eats it up; the bottleneck is elsewhere; the time has no destination
What leadership does
Measure against a comparison (metrics 6 and 7) and decide in advance what you will do with the time
Some teams doing very well, the rest not
Hypotheses to investigate
Undocumented practice; licenses poorly distributed; key-person dependency
What leadership does
First verify the quality of the core group’s work, document its practice and extend it to peers with the same tasks
The first two actions have an experimental precedent, not a guarantee; the rest are consulting judgment. In three experiments with 4,867 developers, between 30 and 40% never tried the assistant even though it was free, and at Microsoft two reminder emails lifted sign-ups from 8.5% to 42.5%.
The first 90 days
Roadmap · 90 days
- 1
Days 1 to 30
Baseline
Write down the definitions. Build the process inventory for two or three functions. Compute metrics 1 to 5 and check the two alerts. That first measurement is your baseline, the starting point everything else will be compared against. Do not set targets yet.
- 2
Days 31 to 60
Priority processes
Choose two or three processes with volume and a clear owner. Add the assisted-step flag. Define in advance the outcome metric, the quality guardrail and the decision rule: «if X improves without Y getting worse, we scale.» Roll AI out in stages: one team now, a comparable one eight weeks later.
- 3
Days 61 to 90
Second measurement and decision
Repeat metrics 1 to 5, compute 6 to 8 and decide process by process: scale, redesign or stop.
The staged rollout is what separates observing an improvement from demonstrating that AI caused it: a simple before-and-after cannot tell the tool from the season or the team’s enthusiasm. You do not need an academic trial. You need one group that does not have it yet.
- Before and after
- Comparable team
- Staged rollout90-day plan
- Random assignment
And never swap measurement for perception. In METR’s first experiment—METR is an independent institute that evaluates AI models—experienced developers took 19% longer with AI and believed they had been faster. Its later measurements can no longer tell the effect from zero, and the organization acknowledges selection problems in its own design. In Denmark, a study using administrative records ruled out effects larger than 1% on earnings and hours worked, even though users reported saving 2.8% of their time.
When less AI is better
Go back to the air fryer. Its value is not in using it more, but in using it where it belongs.
The Department for Business and Trade evaluation observed tasks with and without the assistant, on small samples.
Summarizing reports
Faster and better with AI
Spreadsheet data analysis
Slower and worse with AI
It found no robust evidence that the time saved translated into productivity. A usage metric would have rewarded both tasks equally.
The metric becomes the target. Reward activation and you will get activation: trivial actions performed to show up on the dashboard. That is why the scorecard ranks teams and does not grade people.
The dashboard estimates what it did not measure. Microsoft’s «assisted hours» multiply each action by six minutes and by a rate of $72 an hour. The documentation describes them as broad approximations. They are useful for spotting trends, not as evidence of value.
The costs that are not on the slide. Reviewing, correcting and maintaining is work too. On the blog I called it review debt (in Spanish), and it is the reason metric 8 subtracts before it multiplies. Add model consumption, which grows with usage and is rarely allocated by process.
Where the evidence is weak
Swipe the table →
| Claim in this article | What it rests on | Caution |
|---|---|---|
| The adoption figure depends on the window | UK public evaluations and vendor documentation | Public sector, one product, licenses partly handed to volunteers |
| Usage does not imply productivity | Evaluation with observed tasks; experiment at 66 firms; Danish records | Small observation samples; three of the experiment’s four authors work at Microsoft; a single country |
| Perceived savings are unreliable | METR experiment | Sixteen developers in the first measurement; unstable later results |
| Reminders and role-based training move activation | Field experiments | Noisy estimates; software sector |
| The «9 of 12 weeks» threshold | One vendor’s rule | Unvalidated: nobody has shown it predicts retention or results |
| Use outside provided tools measured through network traffic | IT security practice | It only sees the corporate network: personal phones are out of view. It is a lower bound |
| Process coverage, integration, the two-evidence rule and the four layers | My own synthesis and design | Not comparatively tested on a real portfolio |
Three gaps matter more than the rest. Outside a handful of public-sector evaluations and engineering teams, almost no company publishes its internal adoption metric with a method. National statistics will not give you a benchmark either: they count firms that answer «yes,» so one license weighs the same as a redesigned operation. And no source publishes what share of its activity comes from the most active 10%.
A caveat on my own argument
The reasoning seems sound to me: separating layers keeps you from mistaking one metric for the next. I would not defend the exact choice of eight metrics as the only one. And there is a cost I did not solve: measuring integration and outcomes means flagging systems and sustaining comparison groups, and a small business can spend more on measuring than AI gives back. For that business, three numbers—habitual use, one flagged process and its metric against a comparison—may be the whole scorecard. And giving up surveys has a price: records tell you what happened, not why. When a team does not use the tool, the reason is in no system; you have to sit down with the people doing the work. That is diagnosis, not a metric, which is why it stays off the scorecard.
What would change my mind? Seeing, in data from several companies, that 28-day activation alone predicts the operating outcome months later. If that held up, most of this scorecard would be unnecessary.
Conclusion
Northgate was neither behind nor ahead. It was measuring the purchase of the air fryer.
Once it separated the four questions, it stopped arguing about whether 80% was a lot or a little and started arguing about why only one process ran through AI, why that process was faster with more errors, and where sixty hours a month were going. None of those conversations required a new platform. They required definitions, a spreadsheet and the willingness to look at a less flattering number.
Perhaps the most honest measure of maturity is this: how long it takes a company to change the question. No longer how much artificial intelligence it uses, but what it is managing to do better because of it, and with what evidence it could prove that to someone who was not in the room.
Frequently asked questions
What is AI adoption in a company?
It is the degree to which artificial intelligence is used routinely in real work, not the number of licenses bought or people trained. It helps to separate it from activity (access and first use), transformation (processes that changed) and impact (verifiable results). Each is measured with a different metric.
How do you calculate the AI adoption rate?
It depends on what you want to know. Activation divides people with at least one action in 28 days by people with access. Habitual use divides people active in at least 9 of 12 weeks by activated people. Always state the numerator, the denominator and the window, because the same rollout can show 80% or 21% depending on the definition.
How many KPIs do I need to measure AI adoption?
Eight cover the four layers: access, activation, habitual use, process coverage, workflow integration, operating outcome against a comparison, quality and rework, and net time recovered. A small business can start with three: habitual use, one flagged process and its outcome metric against a comparison team.
Is there a standard for measuring AI adoption?
No. The NIST risk framework and ISO/IEC 42001 deal with governance and risk management, not usage metrics. What circulates as «breadth and depth» is a useful lens whose definitions vary by author. Vendor metrics are common practice, not standards.
Does time saved with AI count as productivity?
Not by itself. The time people say they save is usually more than the measured time, and from the measured time you must subtract the new time spent on review and correction. What is left is capacity, and it only becomes value when it has a verifiable destination, such as more volume handled or a cost that is no longer incurred.
Is there a template to calculate these metrics?
Yes. The AI adoption scorecard calculates the eight metrics and the two alerts with Northgate’s sample data or with yours, loaded from CSV templates. It shows where each number comes from and processes the data in your browser.
Sources and further reading
From Philia Sophia
- AI adoption scorecard: interactive template with the eight metrics
- AI ROI is not calculated, it is demonstrated (in Spanish)
- AI-native is not having more AI: it is learning to redesign work (in Spanish)
- The prompt is not the problem: 2 maps for using AI with judgment (in Spanish)
- An agent is not just the model: four pieces for delegating with judgment (in Spanish)
- Data analytics in 5 levels (in Spanish)
Public evaluations and vendor documentation
- Government Digital Service — Microsoft 365 Copilot Experiment: cross-government findings
- Department for Business and Trade — Microsoft 365 Copilot evaluation
- Microsoft Learn — Copilot Dashboard: metric definitions (vendor documentation)
Studies with a published method
- Dillon, Jaffe, Immorlica and Stanton — experiment at 66 firms
- Cui et al. — three experiments with developers
- Humlum and Vestergaard — Large Language Models, Small Labor Market Effects
- METR — update on its productivity experiments
- Federal Reserve — Monitoring AI Adoption in the U.S. Economy
Surveys cited as contrast (self-reported)
Is your leadership team applauding a percentage, or answering the four questions?
I can help you set the baseline, choose the processes and stand up your company’s minimum scorecard. If you would rather start on your own, the scorecard is free.
Let's talk on WhatsAppTransparency note. This article was researched and written by Javier Forero Ruiz with AI assistance for source discovery, cross-checking, editing and verification. It draws on three deep-research reports produced with different AI systems, whose conclusions were checked against one another and against the original sources. Northgate Supply is a fictional company and its figures are hypothetical. The theses, the selection of evidence and editorial responsibility are mine. This English version is a localization of the Spanish original.
Deja una respuesta